

ユースケース
Web/モバイルサービスでのリアルタイムAI推論用ワークステーション
AI 推論・運用
開発・検証フェーズを終えたAIモデルを実サービスや社内業務に安定して組み込む段階では、学習時とは異なる要件が求められます。低レイテンシでの同時リクエスト処理、24時間365日の連続稼働への耐久性、そして社内データを外部に出さないセキュアな推論環境——クラウドAPIではコストと機密性の両面で限界が生じます。サードウェーブのAI推論・運用向け構成は、Webサービスでの大規模同時推論から工場ラインのリアルタイム検知、社内チャットボット・文書要約ツールの日常運用まで、用途と規模に応じた推論基盤を構築できます。掲載モデルはCTOによるGPU構成・メモリ容量のカスタマイズに対応しており、運用環境や予算に合わせたフルオーダーメイドのご相談も承ります。
用途
- 自社業務データを使った小規模LLMのファインチューニング
- Web/モバイルサービスでのリアルタイムAI推論
(チャットボット、対話型検索、コンテンツ生成、推薦システム)
背景と課題
「サービス本番環境で数百〜数千ユーザーの同時クエリを処理したいが、クラウドAPIではレイテンシとコストが課題になっている」「オンプレミスで大規模LLMを動かそうとしても、VRAM不足でバッチサイズが小さくレスポンスが遅い」「評価段階から本番運用まで安定して回せる高信頼マシンが欲しい」——そのようなお悩みにお応えします。
ご提案構成内容
-
高いコア数により、サービス入力クエリの前処理(トークナイズ、プロンプト構築、バッチパディング、入力正規化)を並列に高速処理。AVX-512対応によりCPU側の軽量演算性能も強化されており、GPUへのデータ供給における処理遅延の低減に貢献します。高負荷かつ連続運用を想定した構成であり、トラフィックピーク時におけるCPU側ボトルネックの抑制が可能です。
-
Blackwellアーキテクチャによる96GB GDDR7 ECC VRAMを2〜4基搭載。合計最大384GBの広大なビデオメモリ領域により、大規模モデルの分散推論や大量のKVキャッシュ保持に対応し、高スループットなリアルタイム推論を実現します。省電力・低発熱設計に最適化されたモデルを採用することで、4枚構成時の熱負荷を低減し、長期間の連続稼働においても一貫したパフォーマンスを維持。FP8/INT8等の低精度演算を活用することで、レイテンシを抑えた高効率なサービス運用を可能にします。
-
ECC Registered DIMMの採用により、サービスログやキャッシュデータのビットエラー耐性を向上。512GBの大容量構成により、大規模入力バッチやKVキャッシュの保持など、推論ワークロードにおけるメモリ要求に対応します。DDR5-5600の高帯域により、CPU側でのデータ前処理およびメモリアクセス性能を向上させます。
-
巨大なモデルの迅速なロードと、膨大なサービスログの記録を両立するため、物理的に独立した高速な最新世代NVMe SSDを作業領域に割り当てています。物理2ドライブ構成にすることで、ログの書き込み負荷が推論処理のレスポンスに影響を与えることを回避。ストレージのボトルネックを解消し、ミッションクリティカルなAIサービス運用を支援します。
このような方へ
-

AIサービスエンジニア(推論基盤構築・運用担当)
おすすめ製品
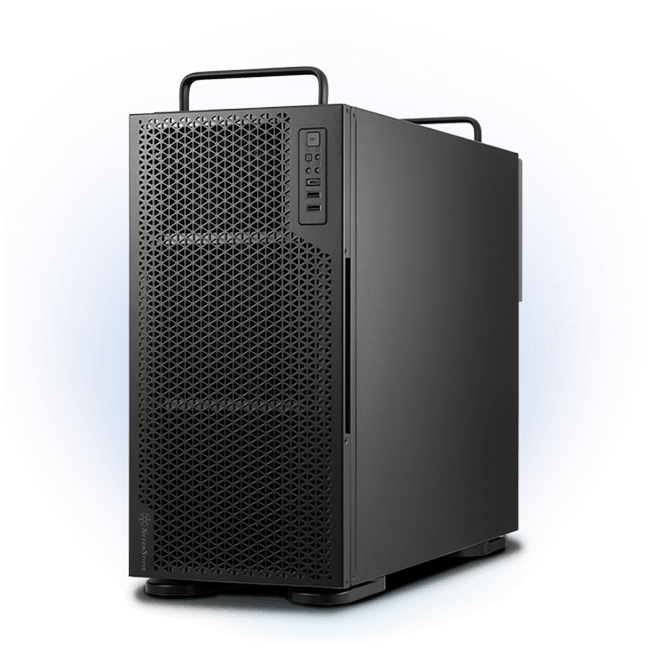
THIRDWAVE Workstation N8632
| OS | Windows 11 Pro 64bit |
|---|---|
| CPU | AMD Ryzen Threadripper PRO 9995WX |
| グラフィック | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition 96GB ×4枚 |
| メモリ | 512GB (DDR5-5600 ECC RDIMM/164GB ×8) |
| ストレージ | 2TB SSD (M.2 PCIe 4.0 x4 NVMe) ×1 8TB SSD (M.2 PCIe 4.0 x4 NVMe) ×1 |
| 保証 | 3年間のオンサイト保守(Bronze_9:00-17:30) |
※掲載スペックは一部構成を変更したモデルです。構成内容は変更となる場合があります。