

ユースケース
大規模言語モデル(LLM)および
生成AI開発用ワークステーション
AI 学習・検証
大規模言語モデル(LLM)や生成AIの実用化が加速するなか、AI開発の主戦場はクラウドからオンプレミスへと広がりつつあります。機密データの保護、月額コストの抑制、実験の再現性確保——これらはクラウドAPIだけでは解決しにくい課題です。一方、ローカル環境での学習にはVRAMの容量不足、CPU前処理のボトルネック、長時間連続稼働への耐久性という別の壁が立ちはだかります。サードウェーブは、数百億パラメータの大規模学習から7B〜13Bクラスのファインチューニングまで、目的とコストに応じた最適なAI学習・検証環境を国内生産ワークステーションでご提供します。掲載構成はCTOによるGPU増設・メモリ拡張などのカスタマイズに対応しており、研究・開発の規模に合わせたフルオーダーメイドのご相談も承ります。
用途
- 大規模言語モデルのファインチューニング(数十億〜数百億パラメータモデル)
背景と課題
LLMのフルパラメータファインチューニングや高度な画像生成モデルにおいて、数兆スケールの大規模トレーニングをシングルノードで実現したいのに、VRAM不足とCPU・メモリのボトルネックで処理が中断しているとお困りではありませんか。研究機関特有の長時間連続実験でエラー耐性と安定性が不足し、イテレーション速度が遅いために論文投稿やプロトタイプ開発のスピードが競争力に直結していませんか。
ご提案構成内容
-
96コアの圧倒的な並列処理性能により、データローディングやトークナイゼーション、画像の前処理を劇的に高速化します。AVX-512対応による演算加速と、AMD Ryzen Threadripper PRO プラットフォームが提供する広大なPCIe帯域により、4基のGPUへのデータ供給を淀みなく実行。LLMや画像生成におけるCPU側のデータ処理ボトルネックを排除し、実験のイテレーション速度を最大化します。
-
96GB GDDR7 ECC 96GB GDDR7 ECC VRAMを搭載したGPUを4基構成。複数GPU環境に対応し、各GPUの計算資源およびメモリを活用したデータ並列・モデル並列によるマルチGPU学習が可能です。第5世代TensorコアによるFP8/FP4低精度演算の高速化により、学習および推論処理を効率化します高効率な排熱設計により発熱・消費電力を抑え、研究室環境での長時間連続稼働にも対応します。
-
ECC Registered DIMMによりビットエラーを検出・訂正し、研究データの長期的な信頼性を確保。512GBの大容量構成により、大規模データセットのインメモリ処理において十分なメモリ容量を確保しています。DDR5-5600の高帯域幅が、CPUでの前処理からGPUへのデータ転送におけるボトルネックを解消します。
-
大規模な学習データセットやモデルの高速な読み書きを実現するため、物理的に独立した高速な最新世代NVMe SSDを作業領域に割り当てています。システムドライブとデータ領域を分離することで、大規模なチェックポイント保存(Save)やデータローディングによる負荷がOSの動作を妨げず、安定した実験環境を実現。ストレージのボトルネックを解消し、研究の試行錯誤を加速させます。
このような方へ
-

LLM・生成AI研究者
-
マルチモーダルモデル開発エンジニア
おすすめ製品
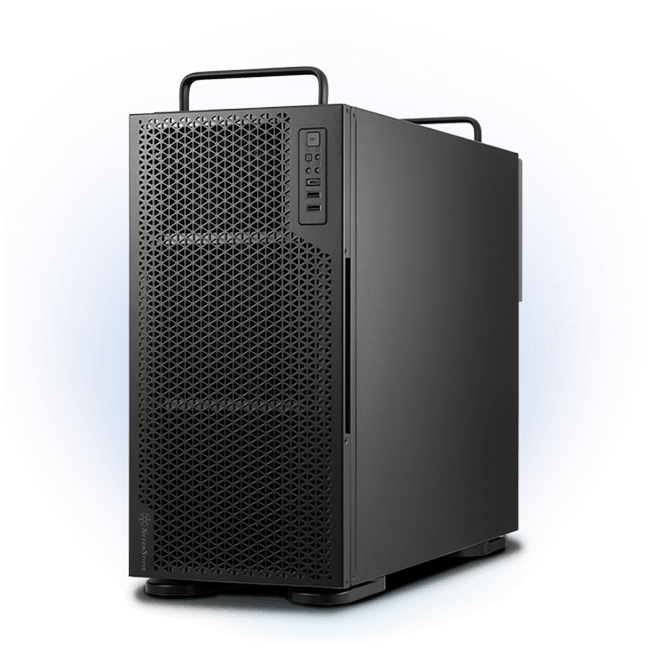
THIRDWAVE Workstation N8632
| OS | Windows 11 Pro for Workstation |
|---|---|
| CPU | AMD Ryzen Threadripper PRO 9995WX |
| グラフィック | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition 96GB ×4枚 |
| メモリ | 512GB (DDR5-5600 ECC RDIMM/64GBx8) |
| ストレージ | 8TB SSD (M.2 PCIe 4.0 x4 NVMe) x2 |
※掲載スペックは一部構成を変更したモデルです。構成内容は変更となる場合があります。